조사 기간: 2026년 10월 16~23일 / 내용 확인: 2026년 10월 23일(한국 시간)
이번 주 레딧의 AI 관련 글을 읽다가 흥미로운 대비를 발견했다. 한쪽에서는 더 강한 모델과 더 빠른 추론 엔진이 잇달아 공개됐다. 다른 쪽에서는 AI 코딩 도구에 맡겨 둔 API 키가 유출됐다는 소식에 사용자들이 불안해했다.
결국 모델이 얼마나 똑똑해졌느냐만으로는 AI 도구의 가치를 판단할 수 없다는 이야기다. 모델을 감싼 프로그램이 어떻게 움직이는지, 실제 비용은 얼마나 나오는지, 권한은 누가 갖는지까지 봐야 한다.
이번에는 r/LocalLLaMA와 관련 레딧 토론 가운데 지난 일주일에 등장한 이슈를 추렸다. 레딧의 주장만 옮기지 않고 가능한 한 프로젝트의 공식 저장소·모델 카드·사고 보도와 교차 확인했다. 인기 순위의 엄밀한 집계가 아니라, 실제로 써 볼 가치와 위험을 중심으로 고른 여섯 가지다.
지난달의 흐름과 비교하고 싶다면 9월 첫째 주 Reddit AI 이슈 정리도 참고할 만하다.
먼저 한눈에 보면
| 이슈 | 확인된 핵심 | 내가 주목한 지점 |
|---|---|---|
| OpenCode Console 보안 사고 | 연동된 외부 AI 제공자 키가 노출될 수 있었고, Console 사용자 약 1.4%가 영향받았다는 발표 | AI 도구를 잘 만드는 것과 비밀키를 안전하게 관리하는 것은 별개의 문제 |
| Google Harness² 공개 | 모델 가중치를 바꾸지 않고 프롬프트·도구·메모리 등의 구성을 반복 개선 | ‘더 좋은 모델’ 대신 ’더 좋은 작업 시스템’을 만드는 접근 |
| DeepSeek V4.1 Flash 1017 | MIT 라이선스 가중치 공개, 100만 토큰 컨텍스트 지원 | 벤치마크가 높아도 로컬 구동 비용까지 저렴한 것은 아님 |
| DeepSeek DeepInfer | 대규모 추론용 엔진을 Apache 2.0으로 공개 | 모델 공개 이후의 경쟁은 실행 엔진으로 번지고 있음 |
| KittenTTS 2 | CPU 구동을 표방한 1.7B 음성 합성·복제 모델 공개 | 음성 AI의 로컬 실행 문턱은 낮아지지만 라이선스 확인 필요 |
| MiniMax M3.1 Flash | 저가 API 출시, 가중치 공개 일정은 추가 확인 필요 | 모델 단가보다 ’작업 하나를 끝내는 총비용’이 중요 |
1. OpenCode Console 사고: AI 코딩 도구에 저장한 API 키가 문제였다
가장 먼저 확인할 소식은 신모델이 아니라 보안 사고다.
10월 17일 OpenCode 측은 자사의 호스팅 서비스인 OpenCode Console에서 보안 사고가 발생했고, 영향 범위가 Console 사용자의 약 1.4% 수준이라고 밝혔다. 문제가 된 사용자는 외부 AI 모델 제공자를 계정에 연결해 사용하던 일부 사용자다. 저장된 API 키가 노출됐을 가능성이 제기됐다.
레딧에는 “키를 교체하라”는 경고가 빠르게 퍼졌다. 일부 사용자는 자신이 승인하지 않은 API 사용 요금이 발생했다고 보고했다. 10월 19일 TechCrunch 보도 역시 공격자가 사용자의 AI 계정에 비용을 발생시킨 사례를 다뤘다.
여기서 구분해야 할 것이 있다. 이번에 확인된 사고 범위는 OpenCode Console이다. ’OpenCode로 코딩하는 사람은 누구나 키가 털렸다’는 식으로 확대 해석하면 안 된다. 로컬에 설치한 CLI 도구 자체에 동일한 침해가 확인됐다는 발표는 아니다.
또 OpenCode가 사건을 ’대규모 증류(distillation) 공격과 관련된 침해’라고 설명했다고 해서, 그 말만으로 침해 경로나 원인이 모두 규명된 것도 아니다. 아직 조사 중이라고 봐야 한다.
내가 이 사건에서 가장 크게 느낀 점은 단순하다. AI에게 코드 작성을 맡겨도 되지만 API 키의 보관과 사용 권한까지 무심코 한 서비스에 몰아주어서는 안 된다.
실제로 확인할 일은 다음과 같다.
- OpenCode Console에 외부 제공자 키를 저장했고 영향 안내를 받았다면 해당 제공자에서 키를 폐기하고 새 키를 발급한다.
- OpenAI·Anthropic·Google 등 연결된 제공자의 사용 내역과 청구 금액을 확인한다.
- 프로젝트마다 별도의 키를 쓰고, 사용량 한도와 결제 알림을 설정한다.
- AI 에이전트에 필요한 권한만 부여하고 작업 환경을 구분한다.
관련 자료: 레딧 사고 토론 · TechCrunch 10월 19일 보도
2. Google Harness²: 모델을 다시 훈련하지 않고 에이전트의 일하는 방식을 개선한다
이번 주 개인적으로 가장 흥미로웠던 공개 프로젝트는 Google Research의 Harness²다. 레딧 r/LocalLLaMA에도 10월 18일 소개 글이 올라오며 관심을 모았다.
여기서 ’하네스(harness)’는 AI 모델 자체가 아니라 그 모델을 둘러싼 실행 환경을 뜻한다. 시스템 프롬프트, 도구 사용법, 안전 규칙, 메모리, 하위 에이전트, 스킬, 스크립트, 플러그인 등이 여기에 들어간다.
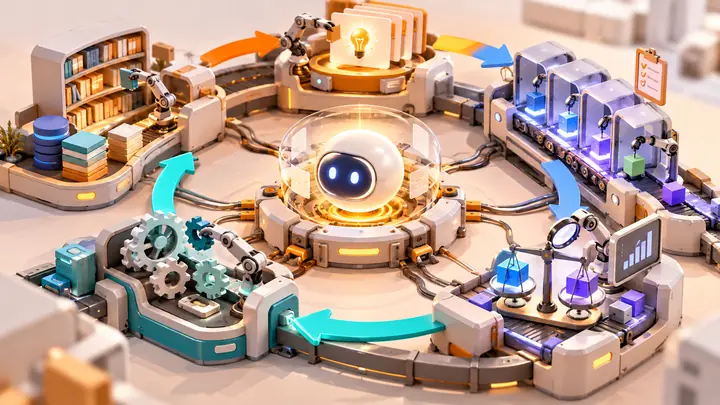
기존에는 사람이 이런 구성을 만들고 모델을 그 안에 넣어 사용했다. Harness²는 한 단계 더 나아간다. 에이전트가 작업하면서 하네스의 수정안을 제안하고, 여러 구성을 시험하고, 결과의 차이를 비교해 채택하는 구조다. 프로젝트 문서에서 설명하는 흐름은 Propose → Probe → Compose다.
중요한 부분은 모델 가중치를 수정하지 않는다는 점이다. ’AI가 스스로 더 똑똑한 모델이 됐다’는 뜻이 아니라, 같은 모델이 더 잘 일하도록 도구와 작업 절차를 재구성한다는 뜻에 가깝다.
연구진이 공개한 자체 평가에서는 한 차례의 하네스 개선만으로 WorkBuddy-Bench에서 최대 11.5점, JobBench에서 최대 4.5점, 법률 분야 LAB의 일부 통과율에서 최대 11.8%포인트 개선을 보고했다. 다만 특정 모델과 평가 환경에서 얻은 결과이므로 모든 실무 작업에 똑같은 향상이 나타난다고 단정할 수는 없다.
내가 주목하는 이유는 모델 교체만으로 해결되지 않는 문제들이 많기 때문이다. 같은 모델이라도 어떤 도구를 언제 호출하는지, 실패했을 때 어디까지 다시 시도하는지, 이전 경험을 어떻게 기록하는지에 따라 결과가 달라진다. 좋은 AI 협업 프로그램은 답변을 잘 쓰는 모델 한 개보다 실패를 줄이는 작업 구조에 더 가까울 수 있다.
관련 자료: 레딧 토론 · Google Research Harness² 공식 저장소
3. DeepSeek V4.1 Flash 1017: 높은 점수보다 실제 사용 조건을 봐야 한다
10월 17일 DeepSeek는 DeepSeek-V4.1-Flash-1017 가중치를 Hugging Face에 공개했다. 모델 카드에는 MIT 라이선스, 최대 100만 토큰 컨텍스트가 명시돼 있다. Hugging Face의 모델 파일 정보에는 약 763B 파라미터라고 표시된다.
DeepSeek가 공개한 자체 시험표에서 Terminal-Bench 4.0 점수는 이전 31.2에서 42.3으로, DeepSWE v1.1은 74.2에서 77.0으로 올랐다. 코딩과 에이전트 작업을 겨냥한 개선이라는 메시지다.
그런데 레딧의 다른 토론에서는 ’이제 오픈 가중치 1위’라는 성급한 그래프 자체가 논쟁거리가 됐다. 실제로 어떤 벤치마크를 수행한 것인지, 독립 기관의 이름과 시각적 형식을 빌려 신뢰감을 주는 것은 아닌지 따져야 한다는 지적이 나왔다.
나는 이 부분에 동의한다. 개발사 발표의 수치는 개발사 자체 평가다. 모델의 성능을 이해하는 자료는 되지만, 내가 쓰는 언어·코드베이스·도구 조합에서도 같은 순위가 나온다는 보장은 없다. 더구나 763B 규모 모델은 ’오픈’이라고 해서 평범한 노트북에 간단히 설치하는 수준이 아니다. 실제 로컬 구동에는 양자화, 메모리, 저장장치, 추론 엔진 등의 조건을 확인해야 한다.
다시 말해 오픈 가중치 여부, 모델 성능, 내가 직접 돌릴 수 있는지는 각각 별도 질문이다.
관련 자료: 레딧 공개 소식 · 벤치마크 신뢰성 토론 · DeepSeek 공식 모델 카드
4. DeepInfer: 이번에는 모델이 아니라 ’돌리는 엔진’을 공개했다
DeepSeek는 모델 발표로 끝내지 않았다. 이번 주에는 대규모 추론 프레임워크 DeepInfer도 공개했다.
공식 저장소를 보면 고성능 커널과 병렬 처리, 비동기 스케줄링, 구조화된 출력, 결정적 샘플링 같은 기능을 다룬다. Apache 2.0 라이선스이며, DeepSeek의 대규모 서비스에 쓰이는 추론 기술을 바탕으로 했다고 설명한다.
이름만 보고 가정용 PC에 설치하는 범용 챗봇 프로그램으로 생각하면 곤란하다. 현재 공식 문서에 적힌 지원 장비는 NVIDIA SM100 GPU와 Huawei Ascend 950 NPU다. 제공된 성능 측정도 입력 처리용 4개, 출력 처리용 64개 SM100 GPU라는 대규모 환경에서 진행됐다. KV 캐시 시스템이나 서비스 수준 로드 밸런싱 등은 별도 구성이 필요하다고 명시한다.
그러니 당장 누구에게나 추천할 소프트웨어라기보다는 고성능 AI 서비스를 만드는 개발자들이 연구할 만한 공개 자산에 가깝다.
이 소식이 의미 있는 이유는 경쟁의 중심이 단순한 모델 점수에서 서빙 엔진의 처리량·지연 시간·비용으로도 이동하고 있기 때문이다. 같은 모델이라도 어떻게 실행하느냐에 따라 사업성이 달라진다.
관련 자료: 레딧 소개 글 · DeepInfer 공식 저장소
5. KittenTTS 2: GPU 없이 음성 AI를 쓰는 선택지가 늘었다
10월 22일 전후로 레딧에서 눈에 띈 또 하나의 공개 프로젝트는 KittenTTS 2였다. 텍스트를 음성으로 바꾸는 TTS 모델인데, 개발사는 1.7B 파라미터, 1.58비트 삼진 가중치, CPU에서도 실시간 생성 가능을 내세웠다.
공식 모델 카드에는 음성 샘플을 사용한 화자 복제, 한국어를 포함한 다국어 음성, 감정·강조 제어 기능이 소개돼 있다. 특히 한국어 음성도 지원 목록에 올라 있다는 점에서 관심이 갔다. 다만 한국어 품질을 직접 측정한 것은 아니며, 개발사 역시 감정 제어 기능을 베타로 표시했다.
파일 용량은 어떤 가중치를 선택하느냐에 따라 달라진다. 모델 카드 기준 기본 packed 가중치는 약 954MB, 더 작고 손실이 있는 emb4 가중치는 약 469MB다. 여기에 음성 디코더 구성도 영향을 준다. ’500MB면 다 해결된다’고 받아들이기보다 실제 설치 구성을 확인해야 한다.
라이선스도 놓치기 쉬운 부분이다. GitHub 코드 저장소에는 Apache 2.0이 표시돼 있지만, Hugging Face 모델 가중치 페이지에는 stellon-labs-community-license가 표시된다. 코드와 모델이 같은 조건으로 배포된다고 가정하면 곤란하다. 특히 음성 합성을 상업 서비스에 적용하려면 해당 모델 라이선스와 화자 음성 사용 권한을 확인해야 한다.
관련 자료: 레딧 소개 글 · KittenTTS 코드 저장소 · KittenTTS 2 모델 카드
6. MiniMax M3.1 Flash: 정말 중요한 건 토큰 가격이 아니다
10월 19일 공개된 MiniMax M3.1 Flash도 레딧에서 빠르게 화제가 됐다. 공식 서비스 페이지에는 이 모델이 제공되고 있으며, 발표 당시 제시된 API 가격은 입력 100만 토큰당 0.15달러, 출력 100만 토큰당 0.60달러 수준이다. 개발사는 이전 M3와 비교해 비용은 약 3분의 1, 속도는 약 3배라는 주장을 내세웠다.
레딧의 관심은 당연히 저렴한 가격과 코딩 성능에 쏠렸다. 하지만 댓글을 보면 벤치마크 점수와 실제 복잡한 작업에서 느끼는 품질은 다를 수 있다는 반응도 있었다. 이것도 특정 사용자의 경험이지 전체 성능을 대표하는 측정 결과는 아니다.
그리고 날짜를 구분할 필요가 있다. Reddit에서는 10월 23일 가중치 공개 예정이라는 정보가 퍼졌지만, MiniMax의 공식 발표문은 ’추후 공개’라고만 안내한다. 10월 23일 내용 확인 시점에 공식 다운로드와 라이선스까지 검증하지 못했으므로 공개가 완료됐다고 단정하지 않겠다. ’공개 예정’과 ’누구나 내려받을 수 있는 상태’는 다르다.
나는 AI 서비스 비용을 비교할 때 토큰당 가격보다 다음 값을 우선 보려 한다. 하나의 작업을 정상적으로 완료할 때까지의 총 사용료다. 한 번에 끝내는 비싼 모델과, 같은 일을 다섯 번 다시 시도하는 저렴한 모델 중 후자가 언제나 더 싼 것은 아니다. 도구 호출 실패와 재시도에 들어가는 사람의 시간도 비용이다.
관련 자료: 레딧 M3.1 Flash 토론 · MiniMax 공식 출시 발표 · MiniMax 개발자 문서
여섯 가지를 묶어서 보니: 이제는 ’모델 밖’의 경쟁이다
이번 일주일을 단순히 정리하면 새 모델, 새 추론 엔진, 새 음성 모델, 새 보안 사고가 각각 있었다고 말할 수 있다. 그런데 이어서 생각하면 같은 방향을 가리킨다.
DeepSeek와 MiniMax는 성능과 비용을 다투고 있다. DeepInfer는 같은 모델을 더 효율적으로 실행할 방법을 보여준다. Harness²는 모델을 바꾸지 않은 채 사용 절차를 개선한다. KittenTTS 2는 한때 GPU가 필요했던 작업을 소비자 장비 쪽으로 끌어온다. OpenCode 사고는 이 모든 기술을 묶은 실제 서비스가 신뢰할 만한지 묻는다.
앞서 AI 협업에서 인지 부담이 늘어나는 이유를 정리했는데, 이번 이슈에서는 작업 구조 자체를 개선해야 한다는 필요성이 더 뚜렷하게 보였다.
내가 AI 자동화 프로그램을 만든다면, 이번 주에 배운 기준을 이렇게 적용하겠다.
- 완료 여부를 먼저 측정한다. ’모델이 답을 했다’가 아니라 필요한 파일·결과·게시물이 실제로 나왔는지 확인한다.
- 실패 원인을 기록한다. 프롬프트·도구·권한·외부 서비스 중 무엇이 문제였는지 남겨 다음 실행을 개선한다.
- 비밀과 권한은 모델 바깥에서 통제한다. AI의 지시를 믿는 대신 키 저장, 격리, 결제 한도와 감사 기록을 따로 마련한다.
- 가격표 대신 작업 단위로 비교한다. 성공률·재시도·실행 시간까지 합친 총비용을 본다.
- 원문 라이선스와 평가 조건을 확인한다. 오픈 가중치, 오픈소스 코드, 상업적 사용 가능성은 같은 말이 아니다.
한 주 사이에 AI 모델 자체는 또 좋아졌다. 하지만 내가 이번에 더 중요하게 본 변화는 따로 있다. 좋은 모델을 고르는 문제에서, 그 모델이 실수하지 않고 끝까지 일하도록 만드는 문제로 관심이 이동하고 있다는 것. 그 변화가 실제 제품을 만드는 사람들에게는 훨씬 크게 다가올 수 있다.
확인한 원문과 자료
- OpenCode Console 보안 사고 관련 레딧 토론
- OpenCode 사고 TechCrunch 보도, 2026.10.19
- Google Harness² 레딧 토론
- Google Research Harness² 공식 저장소
- DeepSeek V4.1 Flash 1017 모델 카드
- DeepSeek 신모델 벤치마크 토론
- DeepInfer 공식 저장소
- DeepInfer 레딧 토론
- KittenTTS 2 모델 카드 및 라이선스
- KittenTTS 2 레딧 토론
- MiniMax M3.1 Flash 레딧 토론
- MiniMax 공식 출시 발표 및 가격
- MiniMax 개발자 문서
이 글은 2026년 10월 23일 확인한 레딧 게시글과 개발사·프로젝트의 공개 자료를 AI의 조사·정리 도움을 받아 작성했다. 커뮤니티의 개인 경험과 개발사 자체 벤치마크를 독립 검증 결과와 구분했으며, 소개한 모델·서비스를 모두 직접 설치하거나 같은 조건으로 측정한 것은 아니다.