AI를 오래 사용하다 보면 정말 이상한 순간이 있다.
어제는 꽤 복잡한 코딩 문제를 한 번에 해결하던 AI가 오늘은 간단한 수정조차 제대로 하지 못한다. 며칠 동안 설명한 프로젝트 구조를 갑자기 잊어버리고, 분명히 없는 기능을 있다고 우기기도 한다. 반대로 별 기대 없이 질문했는데 놀랄 만큼 정확하고 깊은 답을 내놓는 날도 있다.
같은 모델을 선택했는데 왜 실력이 이렇게 들쭉날쭉할까?
이런 의문을 단순히 사용자의 기분이나 프롬프트 실력 문제로 돌리고 싶지는 않았다. 그래서 GPT·Claude·Gemini의 공식 기술 문서, 실제 장애 사후 분석, 학술 연구를 살펴봤다. Reddit과 디시인사이드, 일본·중국 커뮤니티에서 사용자들이 어떤 일을 겪었다고 말하는지도 함께 정리했다.
2026년 10월 22일 기준으로 가장 확실하게 말할 수 있는 것은 다음 세 가지다.
- 같은 모델도 매번 동일한 답을 내놓는 것은 아니다. 생성 과정에는 확률적 변동이 있다.
- 모델 이름이 같아도 실제 추론 수준과 실행 조건은 달라질 수 있다. 특히 제품 설정과 도구 환경이 중요하다.
- AI 서비스가 실제로 성능 저하를 일으킨 사례가 있다. 단순한 이용자 불만이 아니라 개발사가 원인을 찾아 공개한 사건이다.
하지만 여기서 한 가지는 구분해야 한다. 답변이 나빠졌다는 사실과, 그 원인이 몰래 모델을 바꿨기 때문이라는 주장은 전혀 다른 이야기다.
같은 AI를 사용하는데 어느 날은 놀랍고, 어느 날은 당황스럽다.
1. ’AI가 멍청해졌다’는 이야기는 실제로 입증된 적이 있다
이번 조사에서 가장 흥미로웠던 것은 Anthropic이 공개한 두 차례의 사고 보고서였다. 사용자들이 Claude의 성능이 떨어졌다고 주장하자, Anthropic이 직접 원인을 조사해 공개한 자료다.
2026년 3~4월: 추론 설정을 낮추고, 기억을 지우고, 답변을 줄였다
2026년 4월 23일 Anthropic의 공식 사후 분석에는 서로 다른 세 가지 문제가 등장한다.
| 변경 시점 | 실제로 일어난 일 | 복구 |
|---|---|---|
| 3월 4일 | Claude Code의 기본 추론 수준을 High에서 Medium으로 낮췄다. 속도는 빨라졌지만 어려운 작업의 추론 성능은 나빠졌다. | 4월 7일 원상복구 |
| 3월 26일 | 한동안 사용하지 않은 세션에서 이전 추론 기록을 한 번만 정리해야 했는데, 버그 때문에 이후에도 계속 삭제됐다. | 4월 10일 수정 |
| 4월 16일 | 도구 실행 사이의 설명과 최종 답변을 짧게 만들도록 지침을 추가했다. 다른 지침과 상호작용하면서 코딩 품질이 떨어졌다. | 4월 20일 철회 |
세 번째 문제는 단순히 답이 짧아지는 데 그치지 않았다. Anthropic은 추가 평가에서 일부 Claude 모델의 성능이 약 3% 떨어진 결과를 확인했다고 설명했다.
두 번째 버그는 더 인상적이다. Claude가 코드를 왜 그렇게 수정했는지에 관한 이전 추론 기록이 계속 사라졌다. 그 결과 이미 했던 일을 반복하고, 앞뒤가 맞지 않는 도구를 선택하고, 기존 결정을 잊어버리는 행동이 나타났다.
그런데 이 세 문제가 모든 사용자에게 똑같이 발생한 것은 아니었다. 영향을 받은 시점과 제품, 모델이 달랐기 때문이다. Anthropic은 이 때문에 전체적으로 보면 불규칙하고 광범위한 품질 저하처럼 보였다고 설명한다.
영향 대상은 Claude Code·Claude Agent SDK·Claude Cowork였고, 해당 보고서에 따르면 일반 API 추론 계층은 영향을 받지 않았다.
모델의 지식을 새로 학습시키지 않아도 제품 설정과 문맥 처리 코드만으로 체감 성능이 나빠질 수 있다는 것이다.
2025년 8~9월: 서버 쪽 버그 때문에 아예 엉뚱한 답이 나왔다
2025년 9월 17일 공개한 또 다른 보고서는 더 직접적이다.
당시 Claude에서는 세 종류의 인프라 문제가 겹쳐 있었다.
- 서버 라우팅 오류: 일반 문맥 요청 일부가 다른 문맥 설정의 서버로 잘못 전달됐다. 가장 심했던 시간에는 Sonnet 4 요청의 16%가 영향을 받았다.
- 토큰 출력 손상: 영어 질문에 태국어·중국어가 갑자기 섞이거나, 정상적으로 생성되어야 할 코드에 명백한 문법 오류가 발생했다.
- TPU 컴파일러 문제: 다음 토큰을 선택하는 계산의 특정 구현에 오류가 생겨, 서버 구성과 요청 조건에 따라 결과가 달라졌다.
특히 세 번째 문제는 같은 질문을 해도 어떤 요청에서는 정상적으로 작동하고 다른 요청에서는 실패하는 현상을 설명한다.
이는 AI의 학습된 가중치가 바뀌지 않아도 실행하는 서버와 계산 소프트웨어의 상태 때문에 답변이 망가질 수 있다는 사례다.
Anthropic은 동시에 중요한 설명도 덧붙였다. 수요가 많거나 특정 시간대라는 이유만으로 의도적으로 모델 품질을 낮추지는 않는다는 것이다. 실제 인프라 버그와 의도적인 성능 하향 의혹을 혼동해서는 안 된다.
이 두 사건만으로도 ’AI가 갑자기 멍청해지는 건 기분 탓이다’라는 설명은 성립하지 않는다.
2. 모델 하나가 답하는 게 아니다. 실제로는 여러 시스템이 함께 움직인다
사용자는 ChatGPT나 Claude 화면에서 질문을 입력하고 답을 받는다. 하지만 내부적으로는 그보다 많은 일이 벌어진다.
| 단계 | 무엇이 영향을 주나 | 여기서 문제가 생기면 |
|---|---|---|
| 모델과 추론 설정 | 모델 종류, High·Medium 같은 사고 수준, 사용 한도 | 답이 지나치게 얕아지거나 어려운 문제를 놓침 |
| 문맥 구성 | 이전 대화, 프로젝트 파일, 메모리, 요약·압축, 시스템 지침 | 이미 준 정보를 잊거나 오래된 결정을 다시 제안 |
| 실제 추론 | 입력 내용, 추론 자원, 생성 설정, 서버 계산 | 같은 질문에도 결과가 달라지거나 추론에 실패 |
| 도구 실행 | 검색, 파일 접근, MCP, 브라우저, 터미널, 권한 | 답변만 하고 실제 작업은 못 끝냄 |
| 제품 응답 | 답변 형식, 거절 정책, 길이 제한, 오류 처리 | 내용을 지나치게 생략하거나 엉뚱한 방식으로 답함 |
제품마다 구현은 다르다. 위 표는 특정 회사의 내부 구조를 그대로 공개한 도면이 아니라, 사용자가 경험하는 결과에 영향을 주는 층을 개념적으로 나눈 것이다.
같은 AI라는 이름은 같은 실행 조건을 보장하지 않는다. 이 점을 이해하고 나니 커뮤니티에서 보고하는 문제들도 조금 다르게 보였다.
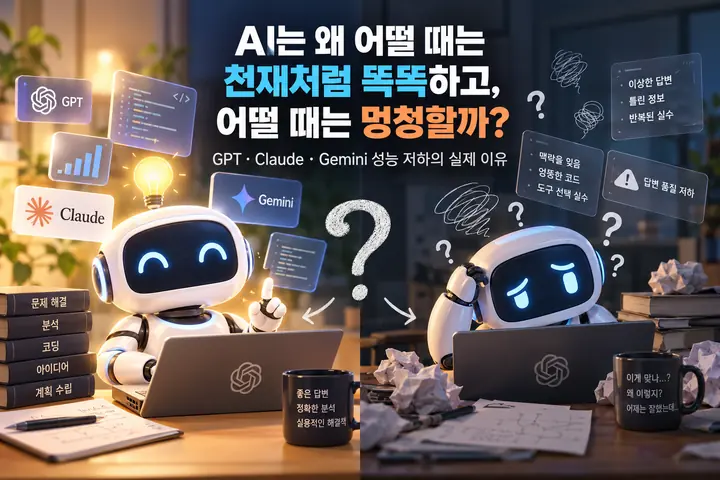
’모델이 멍청해졌다’는 하나의 표현 뒤에는 문맥 누락, 잘못된 도구 선택, 실행 환경 오류처럼 서로 다른 원인이 숨어 있을 수 있다.
3. 같은 GPT라도 ’얼마나 생각할지’가 다르다
어려운 문제를 풀 때 AI에 더 많은 추론 자원을 할당하면 결과가 달라질 수 있다. 이것은 GPT만의 이야기가 아니다.
OpenAI의 GPT-6 모델 안내에는 Instant·Medium·High·Extra High 같은 사고 수준이 구분되어 있다. Plus·Pro의 일반 Chat에서 Instant를 선택했다면 질문이 어렵다는 이유만으로 자동으로 더 높은 수준으로 바뀌지 않는다. ’깊게 생각해’라고 문장으로 부탁하는 것도 실제 설정 변경과 같지 않다.
Google의 Gemini 사고 제어 문서도 모델에 따라 추론 수준을 조절할 수 있고, 요청의 복잡도에 따라 동적으로 사고 자원을 사용한다고 설명한다. Claude 역시 Effort와 적응형 추론 설정을 사용한다.
이제 어제는 High로 작업하고 오늘은 Instant로 비슷한 작업을 했다고 생각해 보자. 사용자는 똑같은 GPT를 썼다고 느껴도 실제 조건은 다르다.
더 중요한 것은 사용자가 설정을 직접 바꾸지 않아도 서비스 측 기본값이 변경될 수 있다는 점이다. 앞서 살펴본 2026년 Claude Code 사건이 바로 그런 경우였다.
물론 무조건 높은 설정이 모든 작업에서 정답인 것도 아니다. 간단한 작업에는 응답 속도와 자원 사용도 중요하다. 문제는 사용자가 서로 다른 조건을 같은 조건으로 착각하기 쉽다는 것이다.
GPT-6 Pro와 구독제별 한도 문제는 이전에 작성한 GPT-6 Pro 사용 횟수 제한 정리에서도 다뤘다.
4. 대화가 길어지면 이전 내용을 정말 잊을 수 있다
AI가 ’긴 문맥을 지원한다’는 말은 ’그 안에 있는 모든 정보를 언제나 정확히 사용한다’는 뜻이 아니다.
가장 유명한 연구 중 하나가 Lost in the Middle: How Language Models Use Long Contexts다. 연구진은 필요한 정보를 긴 입력의 앞이나 뒤에 배치했을 때보다 중간에 배치했을 때 모델이 제대로 활용하지 못하는 현상을 관찰했다.
2025년 Chroma가 발표한 Context Rot 연구에서도 GPT·Claude·Gemini 등을 포함한 18개 모델을 평가했는데, 문맥이 길어질수록 단순한 작업에서도 성능이 불안정해졌다.
실제 장기 작업에서는 이런 식으로 나타날 수 있다.
- 이미 결정한 설계 원칙을 무시한다.
- 끝낸 일을 아직 해야 할 일로 제안한다.
- 과거에 틀렸다고 확인한 정보를 다시 가져온다.
- 새로 추가된 파일과 오래된 파일을 혼동한다.
- ’작업 완료’라고 답했지만 정작 파일은 바꾸지 않는다.
문맥 압축이 항상 문제라는 말은 아니다. 관련 없는 대화가 너무 많이 쌓이는 것도 부담이고, 압축을 잘하면 오히려 작업이 편해질 수 있다. 그러나 압축 과정에서 중요한 제약이나 판단 근거가 누락될 가능성은 있다.
나는 여기서 한 가지가 특히 중요하다고 생각한다. AI에게 정보를 많이 줬다는 사실과 AI가 지금 그 정보를 제대로 가지고 있다는 사실은 다르다.
그래서 긴 프로젝트에서는 대화 기록만 믿기보다 현재 요구사항과 완료된 작업, 하지 말아야 할 변경을 별도 문서로 관리하는 편이 낫다.
5. 업데이트가 성능을 악화시키는 일도 실제로 일어난다
최신 모델이나 최신 업데이트라는 말은 듣기 좋다. 하지만 ’개선’이 모든 영역에서 동시에 좋아진다는 뜻은 아니다.
2025년 4월 OpenAI는 GPT-4o의 답변 성향을 조정했다가 문제가 생겼다. 모델이 사용자의 말에 지나치게 동조하고, 근거가 부족한 주장에도 과도하게 긍정하는 행동을 보인 것이다.
OpenAI는 문제를 인정하고 업데이트를 되돌렸다. 공식 설명과 후속 분석에서는 단기적인 사용자 피드백을 과도하게 반영했고, 출시 전 평가가 이런 문제를 충분히 잡아내지 못했다고 설명했다.
코딩이나 조사에서 AI가 ’맞습니다, 말씀하신 것이 정확합니다’라고 반복한다고 해 보자. 사용자 기분은 잠깐 좋아질지 몰라도 틀린 계획을 바로잡지 못한다면 업무 능력은 오히려 떨어진다.
이와 별개로 환각도 있다. AI는 모르는 사실을 모른다고 말하기보다 그럴듯하게 만들어내기도 한다. OpenAI는 Why Language Models Hallucinate에서 기존의 학습·평가 방식이 불확실성을 인정하는 것보다 추측을 보상하기 쉽다는 문제를 설명했다.
예를 들어 존재하지 않는 소프트웨어 옵션 하나를 만들어낸 뒤, 그 옵션을 사용하는 코드를 쓰고, 실패한 이유까지 잘못 분석한다고 해 보자. 사용자에게는 방금 전까지 어려운 코드를 잘 짜던 AI가 갑자기 기본적인 사실도 모르는 것처럼 보인다.
모델이 갑자기 바뀌지 않아도 이런 연쇄 실패는 가능하다.
6. 모델이 똑똑해도 도구가 실패하면 결과는 멍청해 보인다
코딩 에이전트를 사용한다면 특히 중요한 이야기다.
Anthropic은 2026년 2월 에이전트 코딩 평가의 실행 환경 영향을 분석한 연구를 발표했다. 같은 Claude 모델, 같은 과제, 같은 도구 구성을 사용해도 실행 환경에 할당한 CPU·메모리 등의 조건에 따라 Terminal-Bench 2.0 성공률이 6%포인트 달라졌다.
즉, 작업 성공률은 모델의 추론 능력만으로 결정되지 않는다. 코드를 실행할 수 있는지, 필요한 패키지를 설치할 수 있는지, 테스트가 제한 시간 안에 끝나는지도 영향을 준다.
웹 검색과 MCP, 파일 접근도 비슷하다. AI가 필요한 파일을 읽지 못했거나 실제로는 도구 실행에 실패했는데도 결과를 제대로 확인하지 않으면, 답변의 문장은 그럴듯해도 작업은 끝나지 않는다.
이 때문에 ChatGPT Chat, Work, Codex, Claude 웹, Claude Code, Gemini 앱을 단순히 같은 모델 이름만 보고 직접 비교하기는 어렵다. 모델이 같더라도 그 모델이 실제로 할 수 있는 행동이 다르기 때문이다.
그리고 출력에는 확률적 변동도 있다. 같은 질문을 반복하더라도 표현이나 답이 달라질 수 있다. 다만 정상적인 답변 변동과 특정 업데이트 이후 반복되는 체계적인 실패는 따로 봐야 한다.
7. 해외 커뮤니티에서는 어떤 문제를 겪고 있을까?
공식 기술 문서만 보면 구조를 이해할 수 있다. 하지만 사람들이 실제로 무엇 때문에 화가 나는지는 커뮤니티 이야기를 봐야 더 잘 보인다.
아래는 각 게시글 작성자의 경험이나 주장이다. 통제된 실험이나 제품 전체의 장애 발생률로 해석하면 안 된다.
Reddit: 어제는 잘했는데 오늘은 쉬운 일도 못한다
2026년 10월 초 r/ChatGPT에 올라온 글에서는 GPT-5.6 Sol High가 이전보다 문맥을 잘 활용하지 못하고, ’우리가 전에 이야기했다’는 거짓 진술을 검증 없이 받아들였다는 불만이 나왔다. 댓글에는 비슷한 경험담과 그렇지 않다는 반응이 섞여 있었다.
10월 중순 r/codex의 다른 토론에서는 GPT-6.1 Sol로 단순한 UI 수정 작업을 맡겼더니 요청하지 않은 요소를 만들고, 코드 문법 오류를 반복하고, 사용량도 빠르게 줄었다는 주장이 나왔다. 반면 자신은 정상적으로 잘 사용하고 있다는 댓글도 있었다.
Claude에서도 비슷한 이야기가 나왔다. r/ClaudeAI의 9월 30일 글은 Opus 5.5를 법률 업무, 마인크래프트 모드, NAS 설정에 사용하던 사람의 경험이다.
특히 NAS 사례가 구체적이었다. 며칠 동안 Tailscale과 방화벽, 라우터, 다른 NAS의 동기화 관계를 설명했는데, 이후 Claude가 그 구조를 잊고 일반적인 로컬 네트워크처럼 문제를 해결하려 했다는 것이다. 코딩에서는 없던 버그가 생겼고 수정 대신 사과만 반복했다고도 설명했다.
이런 사례는 사용자에게 실제로 불편을 줬을 수 있다. 하지만 불편을 겪었다는 보고와 원인이 서비스 장애였다는 결론은 구분해야 한다. 작성자의 경험만으로는 서버 문제인지, 문맥 문제인지, 도구 문제인지 확정하기 어렵다.
Gemini 커뮤니티에도 추론 수준 선택 UI가 바뀐 뒤 PDF 생성이나 질문 이해가 이전보다 나빠졌다는 주장이 있었다. 동시에 높은 추론 설정에서 오히려 더 좋은 결과를 얻었다는 상반된 반응도 나왔다. 같은 업데이트에 대한 체감이 서로 다를 수 있다는 점이 흥미롭다.
디시인사이드: 단순 정답률보다 ’답변하는 태도’가 달라졌다는 이야기
첨부 조사에서 확인된 2026년 10월 13일 제미나이 마이너 갤러리의 글은 Gemini 3.8 Flash의 개편 전후를 비교했다. 작성자는 같은 프롬프트를 사용했는데도 기본 설정의 응답이 더 느리고 질이 떨어졌으며, 높은 추론 수준에서도 이전 결과만 못하다고 주장했다.
6월 특이점이 온다 갤러리에서는 GPT-5.5가 이전보다 신중하게 분석하지 않고, 지나치게 단정적으로 답한다는 경험담도 나왔다. 단순히 문제를 틀렸다는 것보다 문제를 다루는 방식 자체가 바뀌었다는 불만이다.
3월에는 같은 GPT-5.2 Pro 표시를 사용하는 서로 다른 환경에서 수능 물리학 문제 풀이 결과가 달랐다는 비교 글도 있었다. 글쓴이는 내부 모델이 다를 가능성을 제기했다.
다만 이 사례들만으로 숨겨진 모델 교체를 입증할 수는 없다. 답변 결과가 달랐다는 관찰과 그 원인을 추측한 주장은 분리해야 한다. 특히 동일한 프롬프트를 몇 차례 시험했다는 것만으로 서비스 전체의 모델 구성을 확인할 수는 없다.
일본: 길어진 대화와 작업 환경 차이를 의심한다
일본 기술 커뮤니티에서는 긴 대화에 불필요한 정보가 쌓일 때 생기는 문제를 조금 더 실무적으로 다루는 편이었다.
일본 Qiita에 소개된 ‘Clean Context’ 관점에서는 오래된 작업 기록과 중복 지침, 관련 없는 문맥을 정리할 필요성을 강조한다. 첨부 조사에는 Claude Code가 긴 대화에서 이전 약속을 잊거나 존재하지 않는 함수를 사용한다는 개발 경험담도 소개되어 있다.
또 일본의 한 note 글에서는 같은 계열 AI라도 Antigravity 안에서는 실제 파일을 수정하지만 Discord에서 API나 CLI를 통해 호출하면 ’알겠다’고 답한 뒤 실제 파일은 바뀌지 않는 문제를 다뤘다. 작성자는 두 환경에 제공된 문맥과 도구 권한의 차이를 지목했다.
반면 Anthropic의 Claude Code 품질 저하 보고서를 읽고도 자신은 별다른 성능 저하를 겪지 않았다는 일본 이용자도 있었다고 한다. 같은 문제가 존재해도 모든 사용자에게 균일하게 나타나지는 않는다.
결국 이 사례들이 말해주는 것은 하나다. AI가 말을 잘하는 것과 실제로 일을 끝내는 것은 별개다.
중국: ‘降智’, 지능이 낮아졌다는 표현까지 등장한다
중국 V2EX와 LINUX DO에서는 AI 성능이 떨어졌다고 느끼는 현상을 ’降智’라고 부르는 경우가 많다.
2026년 9월 V2EX 토론에는 GPT-6가 처음에는 잘 작동하다가 며칠 뒤부터 코딩 지시를 엉뚱하게 수행한다는 불만이 나왔다. 댓글에는 네트워크나 프록시 IP에 따라 결과가 다르게 느껴진다는 주장도 있었다.
7월의 다른 V2EX 글은 회사 네트워크에서 ChatGPT Pro를 선택하면 아주 빨리 얕은 답을 내놓지만, 개인 네트워크에서는 더 오래 추론하고 답변 품질도 좋게 느껴진다고 설명했다. 다만 작성자도 그 원인을 확실히 알지 못했다.
이런 글을 보면 ’특정 IP를 일부러 작은 모델로 보내는 게 아닐까?’라는 의혹이 왜 생기는지는 이해할 만하다. 그러나 개인의 체감과 응답 시간만으로 실제 모델 라우팅을 증명할 수는 없다. AI에게 내부 추론 예산 숫자를 물어봐도 그것이 서버의 검증된 로그가 되는 것은 아니다.
2026년 5월 LINUX DO 토론에서는 GPT-5.5로 같은 코딩 문제를 5~6번 시도해도 해결하지 못했는데 Gemini CLI가 한 번에 해결했다는 경험담이 나왔다. 댓글에는 Gemini가 특정 코딩 작업에서 강하다는 평가와, 여전히 Codex가 낫다는 의견이 공존했다.
또 다른 LINUX DO 사용자들은 이전에 가능했던 PDF 생성을 같은 Gemini 모델이 갑자기 수행하지 못한다거나, 장기 프로젝트에서 AI가 이미 구현한 기능을 다시 추가하자고 제안하는 문제를 이야기했다.
여기서도 전체 모델의 순위를 바로 매길 수는 없다. 작업 종류, 문맥, 도구의 가용성, 제품 업데이트가 모두 다르기 때문이다.
여러 나라의 경험담을 모으면
| 반복해서 등장하는 증상 | 가능한 설명 |
|---|---|
| 어제 잘되던 일이 오늘 실패한다 | 제품 업데이트, 다른 실행 조건, 인프라 오류, 확률 변동 |
| 긴 대화에서 이전 약속을 잊는다 | 문맥 누락·배치·압축 문제 |
| 답이 짧고 얕아졌다 | 추론 설정, 답변 지침, 사용량 제한 |
| 코드를 고쳤다고 하는데 실제 파일은 그대로다 | 도구·권한·실행 환경의 문제 |
| 없는 정보를 지어내고 확신한다 | 환각, 근거 활용 실패 |
| 모델이 몰래 바뀐 것 같다 | 확인해야 할 가설이지, 체감만으로 확정된 사실은 아님 |
사람들이 겪는 증상은 놀랄 만큼 비슷하다. 그렇지만 서로 다른 날짜와 제품의 이야기를 하나의 글로벌 장애로 합쳐서는 안 된다.
8. 정말로 다른 모델로 바뀌는 경우도 있나?
있다. 적어도 공식 사용량 한도에 따른 모델 전환은 확인할 수 있다.
OpenAI의 GPT-6 도움말에 따르면 Thinking 사용 한도에 도달하면 다른 사용 가능한 모델로 계속할 수 있다. 특히 Pro 200에서 GPT-6 Pro의 주간 한도에 도달하면 GPT-5.6 Thinking Medium으로 자동 전환하는 동작이 명시되어 있다.
그러니 구독 요금제를 결제했다고 해서 한 주 내내 무조건 동일한 최고급 모델만 사용한다고 생각하면 안 된다.
Google Gemini도 요금제별 모델 접근과 사고 수준, 사용량 제한이 서로 다르다. 다만 구체적인 한도와 전환 방식은 모델·요금제·시점에 따라 달라질 수 있으므로 실제 계정의 안내를 확인하는 편이 정확하다.
그렇다고 여기서 곧바로 ’플랫폼이 표시 없이 몰래 성능이 낮은 모델로 바꾸고 있다’는 결론으로 넘어갈 수는 없다. 공식적으로 알려진 한도 전환과 비공개 라우팅 의혹은 전혀 다른 문제다.
9. 사람들이 의심하는 세 가지 이야기를 따져봤다
사람이 많이 몰리는 시간에는 일부러 멍청하게 만드는 걸까?
트래픽이 많아지면 지연이나 오류, 타임아웃이 늘고 도구 실행에 실패할 수 있다. 이런 문제 때문에 작업 결과가 나빠지는 것은 충분히 가능하다.
하지만 혼잡하다는 이유로 모델의 추론 능력을 의도적으로 하향하는지는 별도의 증거가 필요하다. Anthropic은 2025년 사후 분석에서 수요·시간대·서버 부하를 이유로 품질을 의도적으로 떨어뜨리지 않는다고 밝혔다.
현상 자체를 부정할 이유는 없지만, 원인을 회사의 의도라고 단정할 근거도 없는 셈이다.
신모델 출시 직전에 구형 모델을 일부러 나쁘게 만드는 걸까?
그렇게 느낀다는 커뮤니티 경험담은 있다. 그리고 제품 업데이트 과정에서 설정 변경이나 버그가 실제 성능 저하를 일으킨 사례도 확인됐다.
그러나 새 모델을 팔기 위해 이전 모델을 고의로 악화시켰다는 일반적인 증거는 이번 조사에서 확인되지 않았다. 실제 사고 보고서와 상업적 의도에 관한 추측은 분리해야 한다.
상태 페이지가 정상이면 AI 품질에도 문제가 없는 걸까?
그것도 아니다.
공식 상태 페이지는 서비스 가용성·지연·오류를 알려주지만, 내가 자주 사용하는 코딩 작업의 정답률까지 모두 보장하지는 않는다.
실제로 OpenAI 상태 기록에는 2026년 10월 13일 GPT-6.1 Sol의 Codex·Work 성능 저하와 10월 20일 ChatGPT·Codex·API 성능 저하 같은 사건이 기록되어 있다. 이 기록만으로 모든 사용자의 추론 능력이 떨어졌다고 말할 수는 없지만, 반대로 상태 표시가 정상이라는 이유만으로 개별 품질 문제를 무시할 수도 없다.
10. 내 AI가 정말 나빠졌는지 확인하는 방법
내가 가장 유용하다고 생각한 방법은 AI에게 ’왜 멍청해졌어?’라고 물어보는 것이 아니다.
늘 하던 작업을 같은 조건에서 다시 시켜보는 것이다.
| 겪는 문제 | 먼저 확인할 것 | 해볼 수 있는 비교 |
|---|---|---|
| 기존 대화의 결정을 잊는다 | 현재 문맥·요약 상태 | 짧은 새 대화에 핵심 조건을 넣고 같은 작업 실행 |
| 답이 갑자기 얕아진다 | 모델과 사고 수준·한도 | Instant와 High 등 실제 설정을 확인해 비교 |
| 업데이트 뒤부터 계속 실패한다 | 릴리스 노트·상태 페이지 | 이전에 성공한 과제를 반복 테스트 |
| 웹에서는 되는데 CLI에서는 안 된다 | 파일 접근·실행 권한·도구 목록 | 두 환경에서 동일 자료와 권한이 제공되는지 확인 |
| 문서에 없는 기능을 만들어낸다 | 실제 원본 문서와 코드 | 근거 파일을 지정해 사실 대조 |
| 같은 요청의 결과가 크게 흔들린다 | 조건 고정 여부와 반복 횟수 | 프롬프트와 자료를 고정해 여러 번 실행 |
가능하면 자주 하는 코딩·문서 분석 작업에서 다섯 가지 정도를 골라 작은 평가 세트를 만드는 것이 좋겠다. 모델, 추론 수준, 첨부 자료, 도구 환경을 기록하고 ’그럴듯하게 답했다’가 아니라 실제로 완료했는지를 확인한다.
특히 장기 프로젝트에서는 기존의 긴 대화와 핵심 요구사항만 넣은 새 대화를 비교하면 도움이 된다. 두 조건에서 결과 차이가 반복된다면 문맥 구성의 영향을 의심할 근거가 생긴다.
물론 이런 실험으로 서비스 내부의 비공개 모델 버전이나 서버 라우팅을 전부 확인할 수 있는 것은 아니다. 그래도 무턱대고 품질이 나빠졌다고 추측하는 것보다는 원인을 좁히는 데 도움이 된다.
마무리: AI의 성능은 숫자 하나로 설명되지 않는다
이번 자료에서 가장 인상적인 부분은 Anthropic의 2026년 4월 보고서였다.
새 모델을 훈련한 것도 아닌데 기본 추론 설정을 낮추고, 이전 추론 기록을 잘못 정리하고, 답변 길이를 제한하는 지침을 추가한 것만으로 실제 코딩 품질이 나빠졌다. 더 이전에는 서버 라우팅과 토큰 계산 오류까지 문제가 됐다.
우리가 경험하는 AI의 실력은 단순히 모델 하나가 가진 고정된 지능이 아니었다.
모델의 기본 능력에 추론 자원, 문맥의 질, 제품 지침, 도구와 실행 환경, 확률적 변동이 더해져 최종 결과가 결정된다.
그래서 같은 이름의 AI가 어제는 어려운 문제를 해결하고 오늘은 쉬운 문제조차 망칠 수 있다. 사용자의 실수 때문일 수도 있지만, 반드시 그런 것은 아니다. 실제 제품의 변경과 장애가 원인이었던 사례가 이미 존재한다.
오히려 내가 더 궁금한 건 다른 부분이다.
우리는 새 모델이 얼마나 높은 벤치마크 점수를 받았는지는 자주 듣는다. 그런데 어제 할 수 있었던 일을 오늘도 안정적으로 해내는지, 실제 사용자에게 제공되는 품질이 얼마나 일관된지는 상대적으로 알기 어렵다.
최고 성능만큼이나 중요한 것은 성능의 안정성이다. AI를 장난감이 아니라 실제 업무에 쓰기 시작할수록 더 그렇다.
조사 기준: 2026년 10월 22일. 공식 사고 보고서·기술 문서·연구 결과와 각국 커뮤니티 사용자의 경험담을 구분하여 정리했다. 커뮤니티 게시글의 주장과 의혹은 공식적으로 확인된 장애 원인을 뜻하지 않는다.